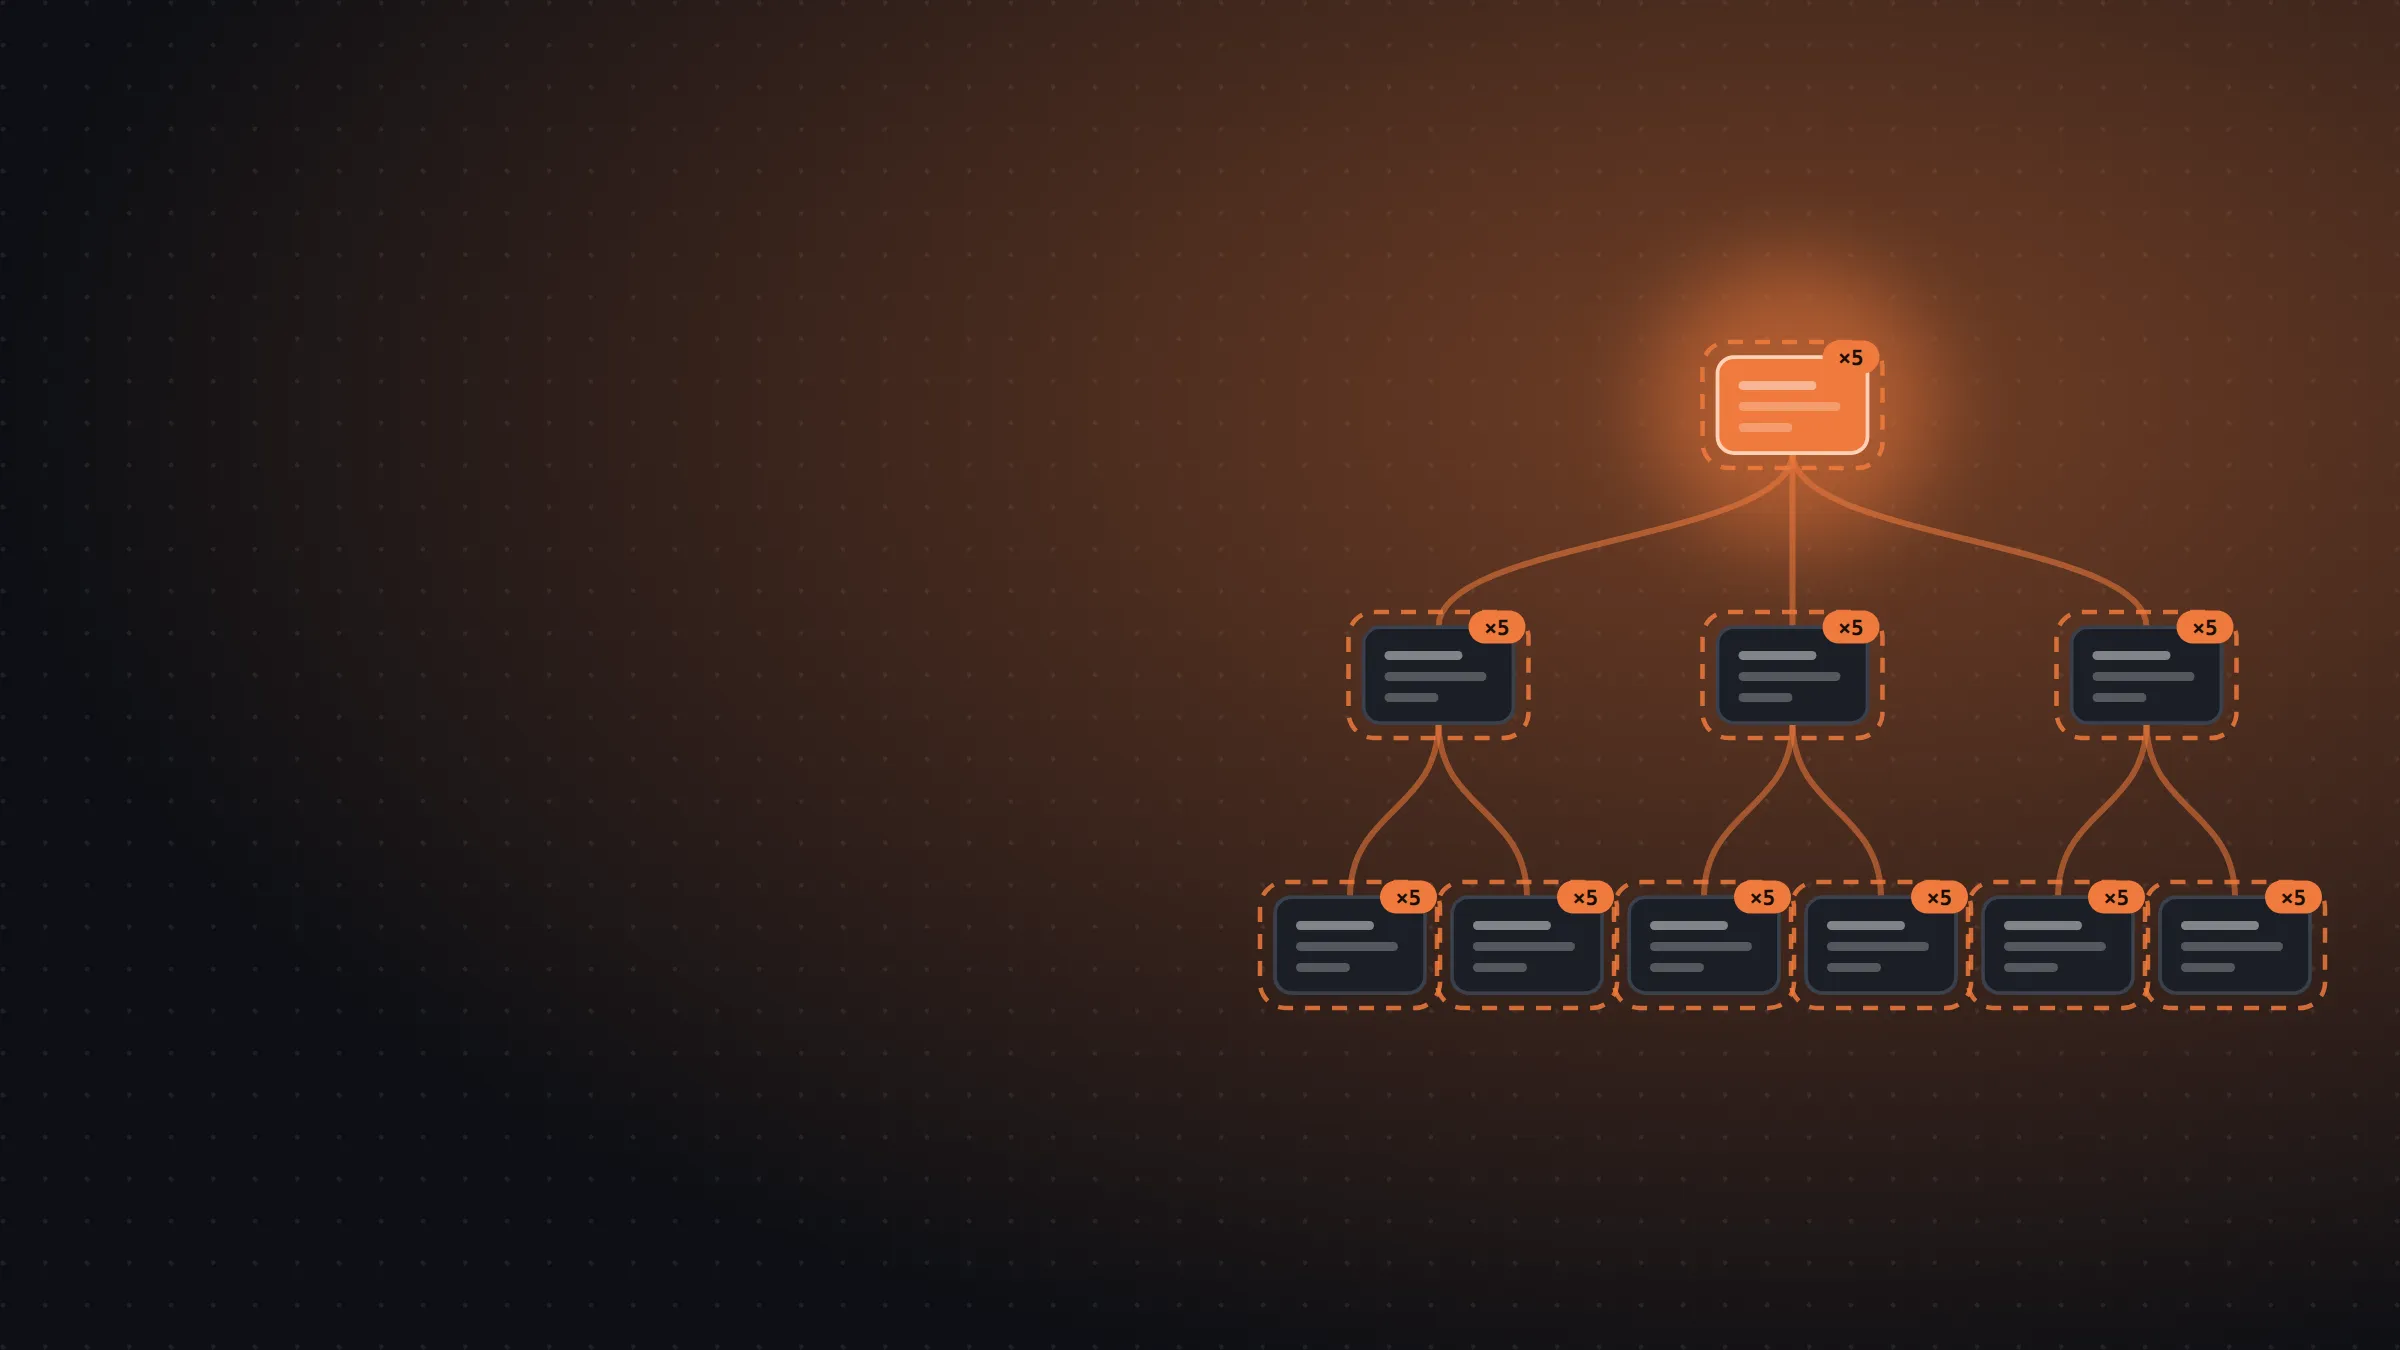
Hoy trabajo así: le doy vueltas a cada idea con /wayfinder o /grill-with-docs, hago un prototipo en HTML cuando hay una pantalla que decidir, convierto lo que sale en tickets, y una cola de agentes los construye y mergea sus PRs mientras yo pienso en lo siguiente.
Cuando empecé a construir Peak Health con agentes, lo primero que instalé fueron las skills de Matt Pocock. Una skill es un fichero de instrucciones que el agente carga cuando le hace falta, y las de Matt están pensadas para trabajar las ideas de forma estructurada y llevarlas a cabo. La que más usaba era /grill-with-docs, que te hace una pregunta detrás de otra hasta que el agente y tú entendéis lo mismo por cada palabra del proyecto, y lo va apuntando en un CONTEXT.md (ahora GLOSSARY.md) que luego leen todas las sesiones. Con eso el agente deja de construir lo que le pediste al pie de la letra y construye lo que querías decir.
materialize: mis skills encima de las de Matt
En aquel momento Matt tenía bastantes menos skills que ahora. No existía /implement, por ejemplo, así que la parte de planificar estaba muy bien cubierta y la de construir la tenía que ir montando yo en cada sesión. Así que me hice las mías encima de las suyas, y de ahí salió materialize.
La idea de tener flujos distintos según el tamaño del trabajo la saqué de HumanLayer. No tiene sentido que arreglar un bug pase por el mismo proceso que una funcionalidad con especificación, por eso materialize tiene una única skill, /materialize, que te recomienda qué tipo de ceremonia necesita cada idea: QUICK para un cambio de una línea, que va directo a implementar y abrir la PR, STANDARD para una funcionalidad normal, con un documento corto que define la feature, y SPEC cuando hace falta definir y escribir el producto antes de tocar código. Las fases se cargan solo cuando llegas a ellas, así que el contexto del agente sigue teniendo solo lo que necesita en cada momento.
Con el tiempo me di cuenta de que Matt ya tenía algo parecido, aunque bastante diferente, con la skill nueva /wayfinder, que planifica el trabajo que no cabe en una sola sesión como un mapa de preguntas abiertas.
Vuelta a las skills de Matt
Abandoné la idea de materialize porque las skills de Matt mejoraron en lo que yo necesitaba. Llegaron /implement, /to-tickets y /wayfinder, y eran más simples que lo que yo había montado. Mantener mis propias skills es mantener otro proyecto, con sus fases, sus referencias y sus fuentes de las que ir sacando ideas, y ese tiempo se lo estaba quitando a Peak Health, que es lo que de verdad quiero construir. Las de Matt ya hacían lo que necesitaba, y además las mantiene él.
La cola que construye los issues sin mí delante
Con /wayfinder y /to-tickets los issues salen definidos de tal forma que se pueden construir sin nadie delante. Matt lo llama trabajo AFK, de away from keyboard, en su diccionario de programación con IA. Lo que me faltaba era una forma automática de construir esos issues AFK sin que yo los supervisara. Si el issue ya dice qué hay que hacer, cómo se comprueba y de qué otros issues depende, no hace falta que yo abra una sesión para cada uno. Así que monté un agente que va cogiendo esos issues uno detrás de otro, y yo me quedo con el trabajo que sí necesita que esté.
En Peak Health se lanza con pnpm queue, un script hecho en Node:
pnpm queue --dry-run   # qué issues cogería y en qué orden, sin empezar nada
pnpm queue             # coge uno, lo construye y para cuando su PR se mergea
pnpm queue --limit 3   # lo mismo con tres, uno detrás de otro
pnpm queue --forever   # todos los que pueda; cuando no quedan, espera diez minutos y vuelve a mirar
pnpm queue --status    # qué ejecuciones están en marcha
pnpm queue --stop      # para después del issue en el que está
pnpm queue --restart   # vuelve a arrancar con el código nuevo, también después del issue en curso
Cada vuelta hace más o menos esto. Lee los issues abiertos de GitHub con la etiqueta ready-for-agent, se salta los que tienen a alguien asignado o un bloqueo abierto, y coge primero los critical y luego el más antiguo. Se lo asigna, deja un comentario en el issue diciendo que lo ha cogido y cuándo. Después crea un worktree de git en .worktrees/issue-<número> y lanza claude -p ahí dentro con el issue en el prompt. La sesión lee las mismas reglas, skills y hooks que cuando trabajo yo, construye el issue con /implement, pasa los checks del pre-push, abre la PR, responde a cada comentario de la revisión de CodeRabbit con la skill /address-pr-comments y, cuando pasan los checks obligatorios y CodeRabbit la aprueba, mergea su propia PR. Si CodeRabbit ha llegado a su límite y no revisa, la sesión no se queda esperando: contesta lo que esté abierto, mergea cuando pasan los demás checks y deja dicho que ese commit no lo revisó nadie. Luego la cola vuelve a leer la lista, así que si durante una vuelta abro un issue critical, va el siguiente.
Que una sesión mergee sus propias PRs puede sonar arriesgado, pero todo lo que construye la cola va detrás de feature flags, así que mergear es seguro: lo nuevo llega a producción apagado y nadie lo puede usar hasta que yo enciendo el flag.
Los checks corren en local, en el Mac, con un git pre-push hook, antes de que exista la PR. Al principio solo corría una ejecución a la vez, pero ahora puedo tener hasta tres terminales con pnpm queue en el Mac. Cada una coge un hueco de los tres, nunca dos cogen el mismo issue, los checks del pre-push van por turnos en el orden en que llegan, y el móvil solo se lo queda una ejecución mientras pasa sus pruebas de Maestro.
Y cuando el issue no deja algo definido y claro, como qué feature flag usa una sección nueva o cómo se dice un texto nuevo que verá el atleta, la sesión no se lo inventa: deja la pregunta como comentario en el issue y para, sin escribir código. La cola le pone entonces needs-info y le quita ready-for-agent, así que el issue no vuelve a la cola hasta que yo conteste.
Jev elige el modelo de cada sesión
No todos los issues necesitan el mismo modelo. Para elegirlo uso Jev, un modelo de TypeSafe que clasifica: le das algo sin estructura y te devuelve una respuesta tipada con su probabilidad. En Peak Health lo uso a través de jev-model-router, un mod de Claude Code que, antes de que empiece el turno, le pregunta a Jev tres cosas sobre el prompt: si el trabajo es mecánico, normal o difícil, cuánto razonamiento necesita, y si hacerlo podría cambiar producción, mover dinero o tocar datos que no se pueden recuperar. Jev nunca ve el nombre de un modelo, solo la descripción del trabajo.
La cola arranca cada ejecución con --model opus y deja que el router elija el modelo de la sesión principal en el primer turno, con el issue entero en el prompt. Según lo que responda Jev, la sesión usa Opus, Sonnet o Haiku. Si Jev ve riesgo, elige el modelo grande y sube el razonamiento a alto pase lo que pase. El router también ajusta el razonamiento de cada turno, de bajo a máximo. Los issues critical no se enrutan y se quedan en Opus. Y si una ejecución acaba en un modelo más barato sin PR y sin comentario, la cola repite el issue en el mismo worktree, esta vez en Opus y sin router.
Los sub-agentes que lanza cada sesión también pasan por el router. En la cola ha pasado lo contrario de lo que esperaba: antes casi todos iban en Sonnet, y desde que existe el router casi todos van en Opus.
Y cada diez PRs mergeadas, la cola lanza una sesión de retro. Lee esas PRs con sus comentarios y revisiones, el log de la cola y las sesiones, y si encuentra un problema que se repite y que ningún issue abierto recoge, abre un issue con el cambio de reglas, checks o skills que lo habría evitado.
Lo que aprendí montando la cola
Nada de esto funcionó a la primera. La primera versión de la cola se dejaba PRs sin abrir, cogía tickets que todavía estaban bloqueados y seguía cogiendo issues cuando algo fallaba por debajo, y cada vez que pasaba algo así lo arreglaba y la volvía a lanzar. Hicieron falta bastantes vueltas hasta que pudo construir y mergear issues de principio a fin sin que yo estuviera mirando, y casi todo lo que sé sobre dejar a un agente trabajando solo lo he aprendido en esas vueltas.
Prototipos en HTML antes de construir
Hay una parte que la cola no puede hacer por mí, y es decidir cómo tiene que ser algo que todavía no existe. Si un issue llega a la cola sin que esté claro qué verá el atleta, la sesión se lo tiene que inventar, y lo que se inventa un agente a mitad de un issue casi nunca es lo que yo tenía en la cabeza. Y si luego tengo que tirar la pantalla, la velocidad de la cola no me sirve de nada.
Por eso, antes de pedir nada, prototipo. Me refiero a una página de HTML que no hace nada pero tiene la interfaz que tengo en la cabeza. La construyo con Claude en un artifact, que me deja verla al momento en el navegador, y a partir de ahí vamos decidiendo sobre ideas concretas: le pido varias versiones de la misma pantalla, las comparo, descarto, pido otra ronda con lo que me ha gustado de cada una y sigo iterando hasta que tengo algo que me convence. Tirar una página de HTML que no está conectada a nada no me cuesta nada, así que puedo probar siete versiones de una pantalla.
Cuando el prototipo forma parte de un mapa de /wayfinder, la página se guarda en la carpeta prototype/ del repositorio, en una rama propia con una PR en borrador que nadie mergea, y en el issue queda escrita la opción que elegí. Esos ficheros ni siquiera pasan los checks del pre-push, porque nunca van a llegar a producción. La decisión sí se queda: cuando el mapa ya no tiene preguntas abiertas, /to-tickets la convierte en tickets que ya dicen cómo es la pantalla, y esos tickets son los que coge la cola.
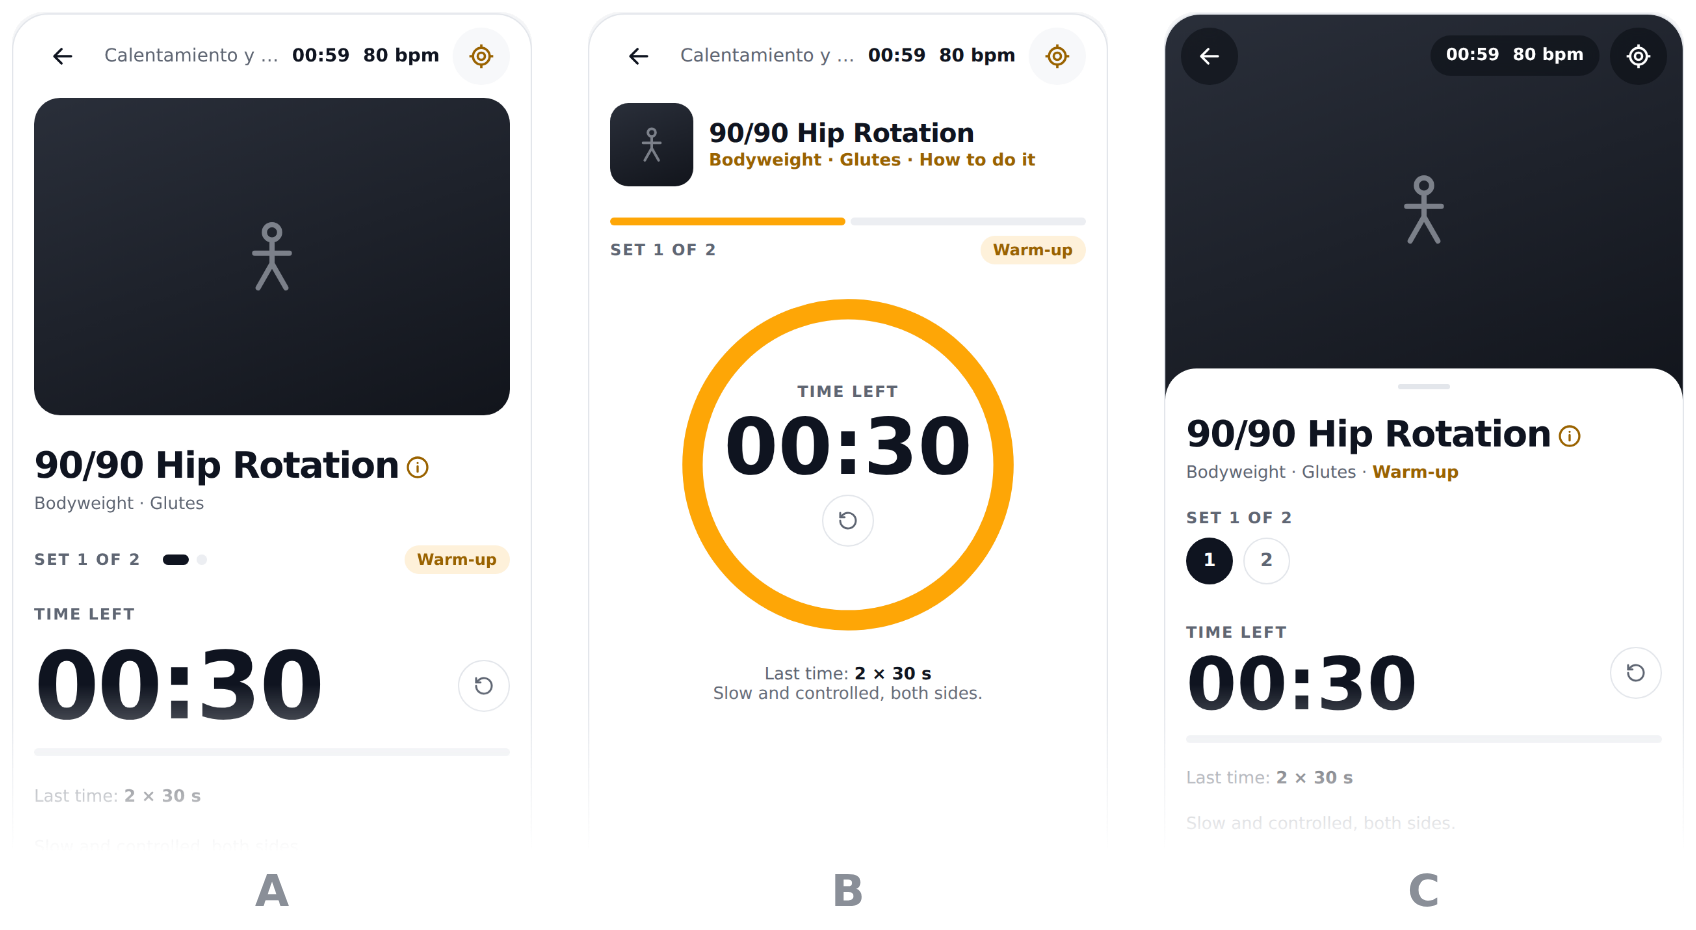
Un ejemplo es la pantalla de una serie en el móvil, la que ves mientras entrenas. Tenía que servir para cuatro tipos de serie: por tiempo, por repeticiones, por repeticiones con tempo y respiración, y una serie de respiración. El prototipo empezó con tres maneras de colocarla. La A lo apilaba todo en una columna, con la foto del ejercicio en una tarjeta y el tiempo grande debajo. La B dejaba la foto pequeña al lado del nombre y ponía el tiempo dentro de un anillo naranja que ocupaba el centro de la pantalla. La C llenaba la parte de arriba con la foto y subía por encima una hoja blanca con el nombre, las series y el tiempo.
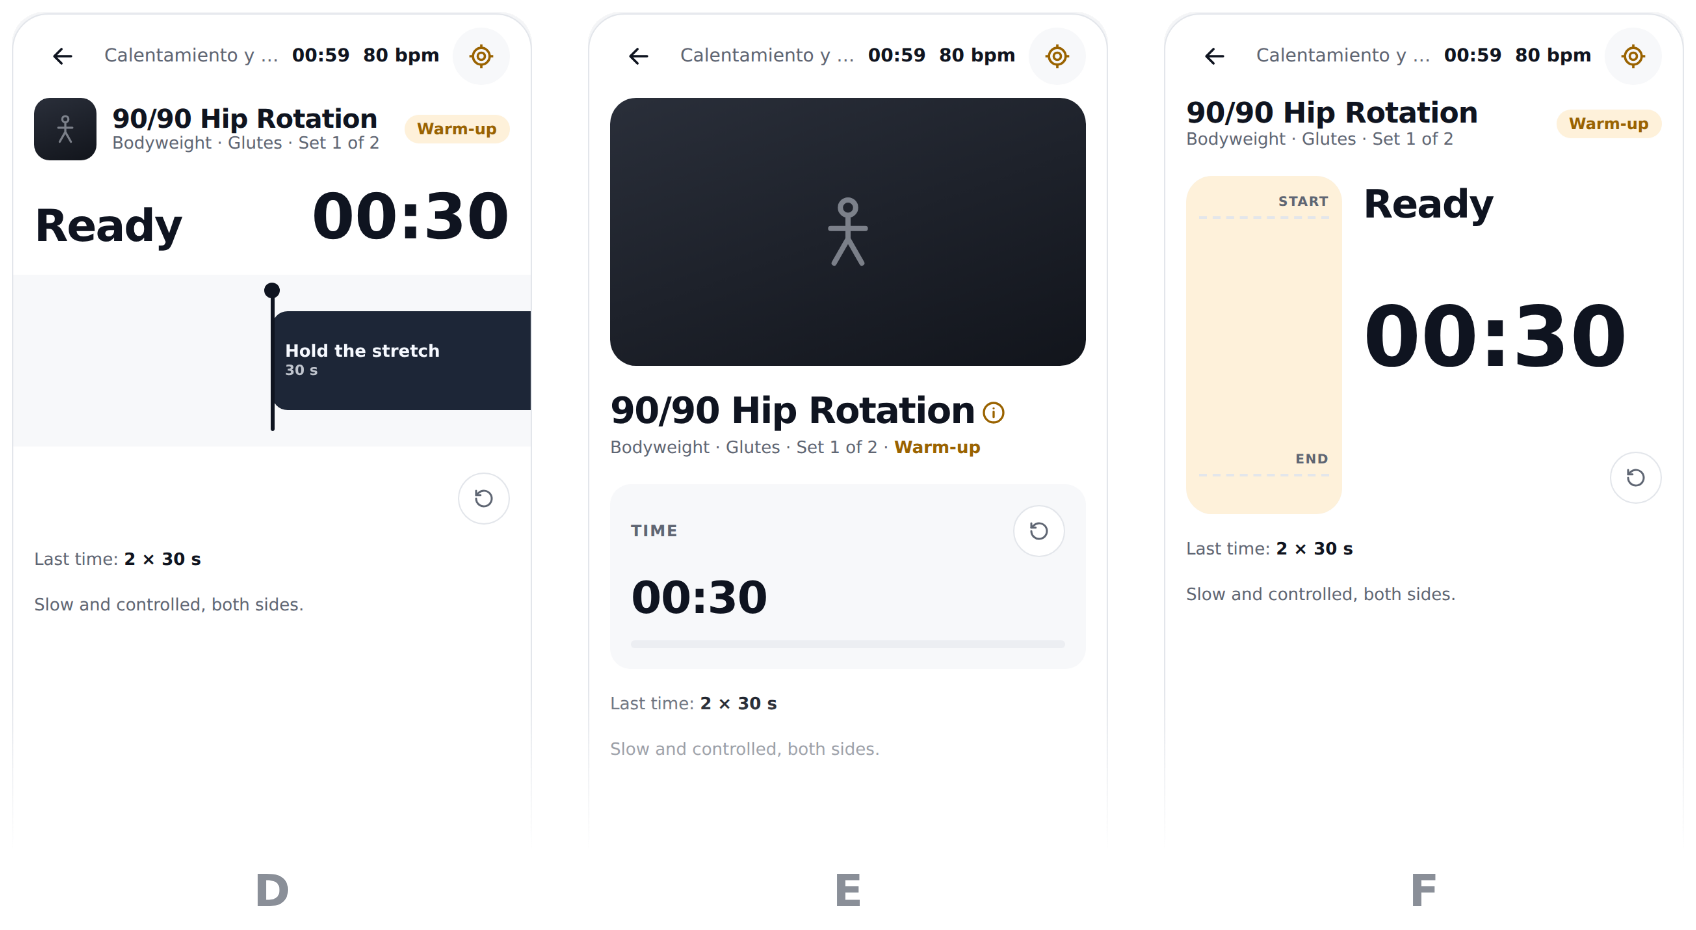
A partir de ahí le fui dando ideas y salieron tres más. La D convertía la serie en una línea de tiempo, con «Ready» y el tiempo en grande encima de una pista que marca cuánto dura cada parte. La E volvía a la foto en una tarjeta y metía el tiempo en una caja propia debajo del nombre. La F ponía al lado del tiempo una barra alta que va de START a END, para que se viera el movimiento mientras pasa.
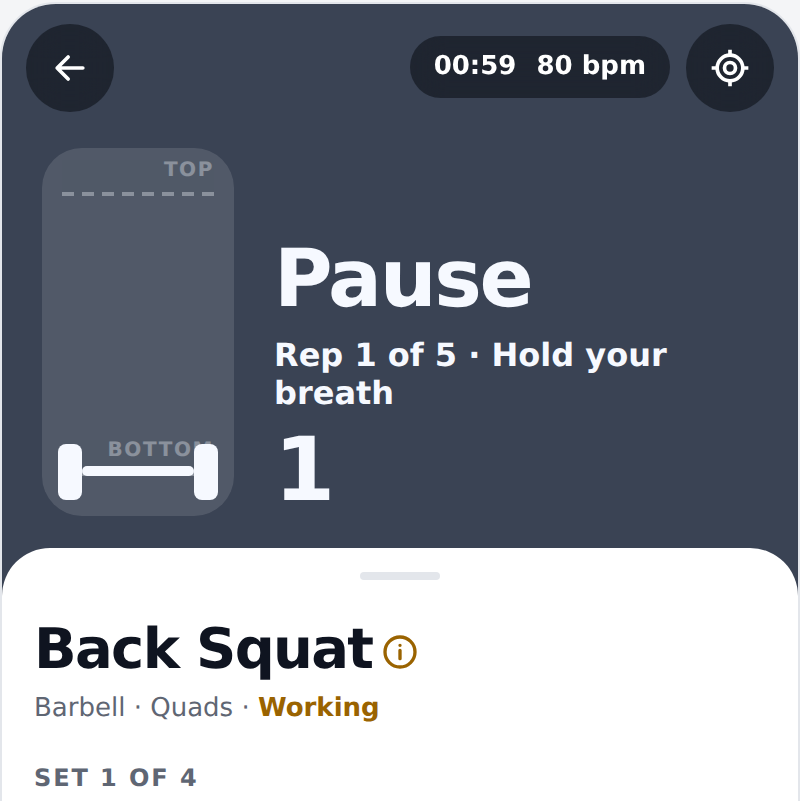
Me quedé con la G, que es la hoja de la C con los botones en una barra abajo, donde al hacer scroll solo se queda «Log». Lo que cambia es la parte de la foto cuando la serie está en marcha: en una serie por tiempo se convierte en una cuenta atrás dentro de un anillo, en una con tempo una barra sube y baja con cada fase de la repetición, y en una de respiración un círculo crece y se encoge al ritmo en que respiras. El prototipo tiene las siete versiones, y con las flechas del teclado pasas de una a otra.
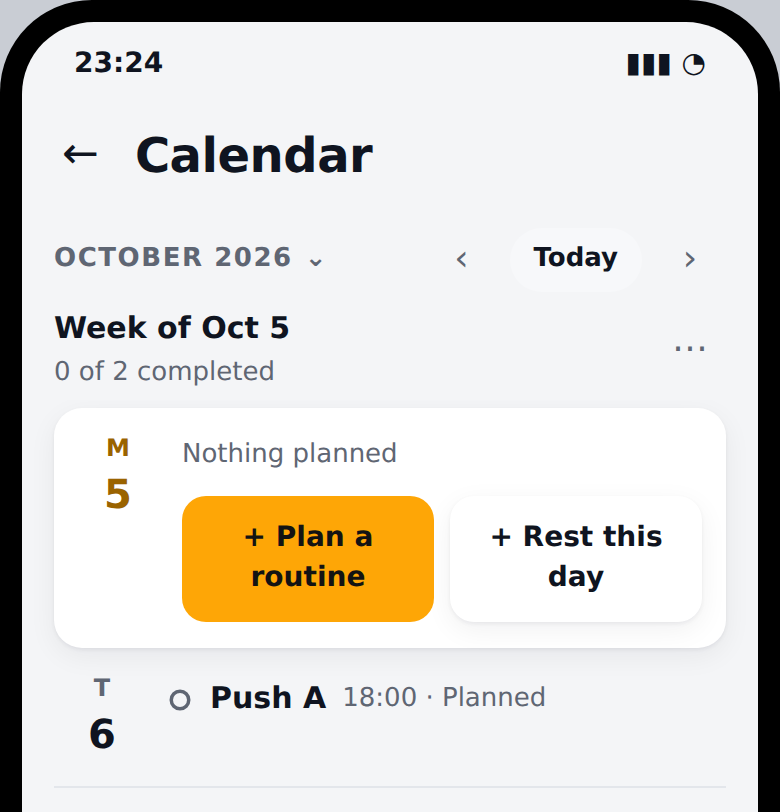
Con el calendario nuevo fue igual pero en dos rondas. En la primera había seis maneras de enseñar los días: un mes que se despliega al tocar su nombre, un tirador debajo de la semana que abre el mes, el mes en una hoja aparte, el mes siempre visible con la semana marcada dentro, los nombres de las rutinas en la tira de la semana, y la que elegí, la D, que quita la tira y enseña los siete días como una lista, cada uno dicho en palabras.
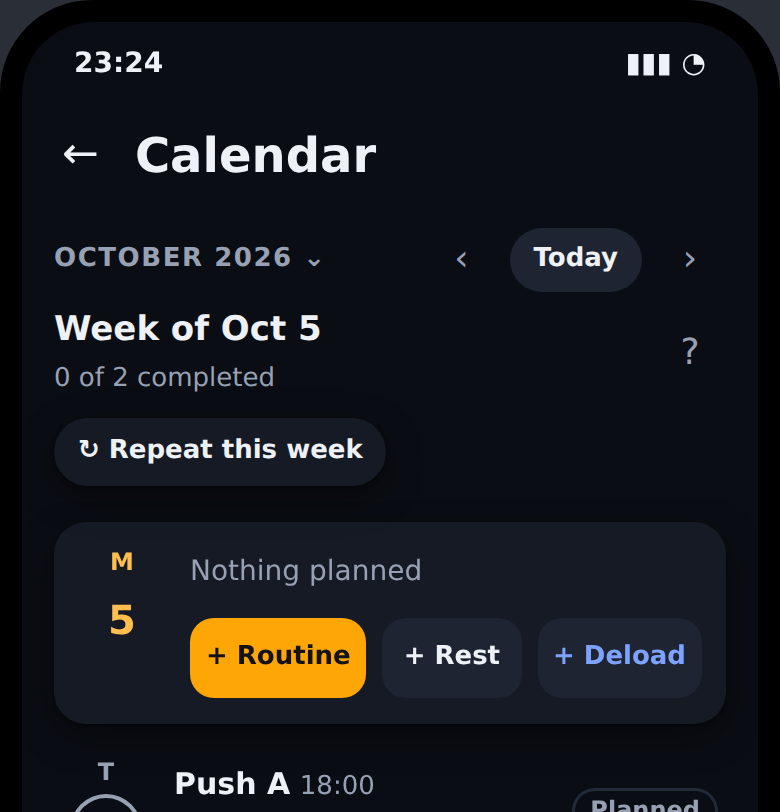
En la segunda, sobre esa misma lista, probé tres formas de decir qué pasó cada día (una palabra de color, un anillo alrededor de la fecha o una frase corta) y tres sitios para la descarga y para repetir la semana (en el menú, en una tarjeta al final de la semana o en el propio día). Me quedé con el anillo en la fecha y con esos botones en el propio día y en cada sesión. De esa decisión salieron cinco tickets, y son los que ahora esperan su turno en la cola.
Cómo trabajo ahora
Ya casi no abro sesiones para implementar features o bug fixes. Desde que existe la cola, casi no he vuelto a escribir /implement a mano, y en el último mes lo que más he usado ha sido /wayfinder y /triage, cada uno en su propia sesión y muchas veces varias a la vez. Uso /wayfinder cuando tengo una idea grande que todavía tiene preguntas abiertas, /triage para poner en orden los issues que van llegando, o hablo de ideas con el agente, y lo que sale de ahí acaba como tickets ready-for-agent que la cola va cogiendo sola. También uso Claude en el móvil mientras uso la app de verdad, cuando encuentro un problema o se me ocurre una idea nueva o una mejora.
Antes me pasaba el día revisando lo que el agente estaba escribiendo. Ahora lo paso decidiendo qué hay que construir y cómo tiene que verse. ¿Y vosotros, cuánto de lo que hacéis cada día podría estar ya en una cola?